El archivo llms.txt no es el nuevo SEO, es la primera señal de una web escrita para máquinas
El SEO lleva mil años teniendo una gran ventaja psicológica y es que todos sabíamos dónde estaba el campo de juego: había una caja de búsqueda, una página de resultados, unos enlaces azules, unos snippets, unas posiciones orgánicas, unos anuncios y una ansiedad bastante estable por aparecer por encima del competidor. Luego llegaron los rich results, los mapas, los carruseles, los vídeos, los marketplaces, los social search y todas esas formas de recordarnos que Google nunca fue exactamente neutral, solo más predecible que lo que venía después. Pero lo que viene después es menos ordenado: el usuario ya no siempre busca, ahora también pregunta, y cuando pregunta a ChatGPT, Gemini, Claude, Perplexity o cualquier asistente integrado en un navegador, un e-commerce, una App bancaria, una plataforma de viajes o una herramienta de productividad, no recibe necesariamente una lista de diez resultados, sino que recibe una respuesta. A veces con fuentes, a veces sin ellas, a veces con una síntesis razonable y a veces con una confianza ofensiva para lo poco que ha mirado. En este contexto aparece algo llamado llms.txt.
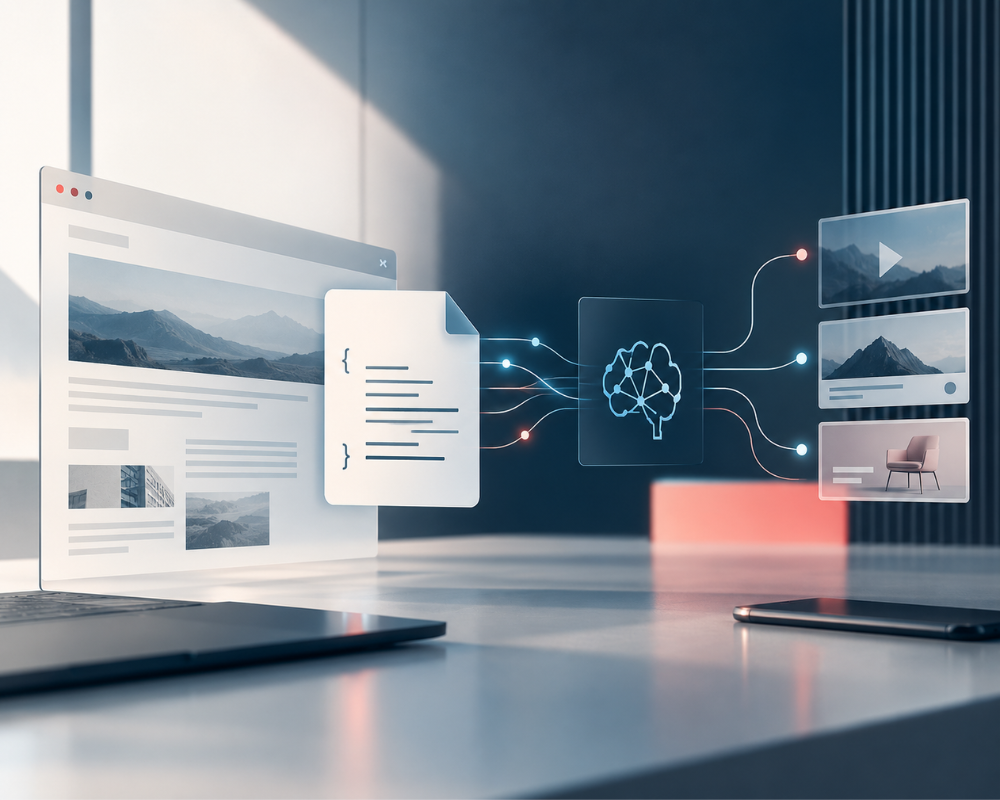
Veamos qué es: llms.txt plantea añadir un archivo /llms.txt en formato Markdown en la raíz de una web para ofrecer a los modelos de lenguaje información que les ayude a usar mejor ese sitio durante la inferencia. No es una tecnología mágica ni un estándar universalmente adoptado, sino más bien una convención emergente o una forma de decirle a una máquina qué es importante, qué páginas representan mejor a una organización y dónde está la información oficial. La comparación con robots.txt es tentadora, pero hay que manejarla con cuidado. Robots.txt sirve para indicar a los rastreadores qué partes de una web pueden o no explorar. Llms.txt, en cambio, no funciona principalmente como una orden de acceso, sino como una guía semántica. Google Chrome, en su documentación de Lighthouse, lo describe como una convención emergente para proporcionar un resumen legible por máquina del contenido de un sitio, especialmente diseñado para LLMs y agentes de IA. Dicho de otra forma menos técnica: robots.txt habla de permisos, mientras que llms.txt habla de contexto.
Para una marca, un publisher, un ecommerce, una entidad financiera, una aseguradora, una universidad o una compañía tecnológica, esto puede parecer otro archivo más, otra tarea para el que lleva SEO, pero la señal de fondo es mucho más interesante: las webs ya no se optimizan solo para ser rastreadas por buscadores, sino para ser interpretadas por sistemas que pueden convertir contenido en respuestas. Los modelos pueden encontrar contenido, pero no siempre saben cuál es la fuente oficial, cuál está actualizada o cuál representa mejor la voz de una empresa y esto le ocurre a cualquier marca cuya información vive dispersa entre web corporativa, PDFs, blogs, notas de prensa, fichas de producto, documentación técnica, reseñas, comparadores, medios, redes sociales, marketplaces, foros y contenidos de terceros.
Y aquí empieza el punto más incómodo para el marketing: durante años hemos tolerado arquitecturas digitales pensadas más para campañas que para conocimiento, léase microsites abandonados, PDFs que nadie actualiza, FAQs que no coinciden con atención al cliente, páginas de producto con claims distintos según el país, blogs que sobreviven por inercia o landings que siguen indexadas aunque la promoción acabó hace tres años. Si un humano se pierde, malo… pero si una máquina se pierde y luego responde con seguridad, peor. Pero ojo que llms.txt no arregla esto, aunque lo deja en evidencia.
No hay aún evidencias públicas suficientes para afirmar que tener un archivo llms.txt haga que una marca aparezca más en ChatGPT, Gemini o Claude. Semrush señala que OpenAI, Google o Anthropic no han declarado oficialmente que sigan estos archivos cuando rastrean sitios web. Ahrefs llega a una conclusión similar: la idea puede ser interesante, pero sin adopción oficial por parte de los grandes proveedores sigue siendo una práctica especulativa más que una garantía de visibilidad. Este matiz es esencial porque el mercado tiene una tendencia maravillosa a convertir cualquier recomendación técnica en un producto milagro. Antes era “pon schema y saldrás en rich snippets”. Luego fue “haz contenido largo y Google te premiará”. Después, “optimiza para E-E-A-T”. Ahora, “crea llms.txt y aparecerás en las respuestas de IA”. La industria cambia, pero la necesidad de vender atajos permanece estable. ¡Qué tranquilidad! La utilidad inmediata de llms.txt no está en garantizar posicionamiento, sino en forzar una disciplina de gobernanza de contenido y obliga a decidir qué información es canónica, qué páginas importan, qué recursos deben ser fácilmente interpretables y qué quiere una marca que una máquina entienda sobre ella. Esto lo convierte en una pieza pequeña dentro de una conversación bastante más grande: GEO, AEO, structured data, knowledge graphs, entity SEO, contenido machine-readable, control de fuentes, reputación en respuestas y medición de presencia en entornos generativos. Podemos decir que llms.txt no sustituye al SEO clásico, sino que se suma a prácticas como datos estructurados, contenido claro y arquitectura de información bien pensada.
El archivo llms.txt, por sí solo, no cambia el futuro, pero simboliza bien el cambio de etapa: la web ya no se construye únicamente para que un usuario navegue, se construye para que una máquina la lea, la comprenda, la resuma, la combine con otras fuentes y, eventualmente, actúe sobre ella. En publicidad digital, esto desplaza parte del valor desde la página visible hacia la capa de conocimiento. Las marcas que tengan información clara, estructurada y consistente estarán mejor preparadas para competir en entornos generativos que aquellas que dependan de contenido disperso, contradictorio o encerrado en formatos poco legibles.
La ironía es que la solución no empieza en la IA; empieza en limpiar la casa, saber qué páginas son oficiales, actualizar documentación, unificar mensajes, aplicar schema cuando proceda, cuidar entidades, revisar FAQs, eliminar contradicciones, separar contenido comercial de documentación, definir qué puede usar un crawler, qué no y bajo qué condiciones. Después, sí, añadir llms.txt puede tener sentido como una capa de orientación, pero venderlo al revés sería otro clásico del sector: empezar por el archivo y olvidar la estrategia.
Para terminar, y a modo de resumen, llms.txt no es el nuevo SEO, sino un recordatorio de que el SEO ya no vive solo en los buscadores, sino también en respuestas, agentes, asistentes, interfaces conversacionales y sistemas que convierten información en decisión. Durante años hablamos de visibilidad como si significara aparecer en una página, ahora empieza a significar aparecer correctamente en una respuesta y eso, para un sector obsesionado con el último click, va a ser bastante incómodo de medir.
Puntos clave:
llms.txt es una convención emergente en Markdown pensada para ayudar a modelos y agentes de IA a entender mejor el contenido relevante de una web.
No hay todavía confirmación pública suficiente de que los grandes proveedores de LLMs lo usen sistemáticamente como factor de visibilidad, ranking o citación.
Para el sector publicitario, el debate real no es técnico, sino estratégico: cómo asegurar que la información oficial de una marca sea legible, estructurada y fiable en la economía de respuestas.
Este resumen lo ha creado una herramienta de IA basándose en el texto del artículo, y ha sido chequeado por un editor de PROGRAMMATIC SPAIN.
