A mí me han explicado el debate sobre identidad digital más o menos así: desaparecen las cookies de terceros, la industria necesita encontrar otra manera de reconocer a las audiencias y aparecen soluciones basadas en emails, identificadores alternativos y distintos sistemas de matching. Hasta aquí, complicado, pero comprensible, pero es que Apple acaba de introducir algo que me resulta, cuanto menos, curioso: ¿y si reconocer a la misma persona entre miles de webs no fuera únicamente un problema de privacidad, sino también de seguridad?
El 19 de octubre, el equipo de WebKit de Apple explicó públicamente que Safari ha empezado a bloquear el acceso de red a lo que denomina identity resolution infrastructure: compañías que actúan como intermediarios para relacionar señales de una persona entre diferentes propiedades digitales. Apple sostiene que estos sistemas permiten reconstruir el tracking cross-site después del bloqueo de las cookies de terceros. Su posición es bastante clara: una web puede utilizar los datos que recoge directamente de sus usuarios para personalizar su propia experiencia; lo que quiere impedir es que un tercero utilice esas señales para reconocer a esa misma persona en otros sitios.
Para entender la diferencia imaginemos algo sencillo: me registro con mi correo electrónico en un periódico; el periódico sabe quién soy porque yo se lo he dicho y puede utilizar esa información, con los permisos correspondientes, dentro de su entorno. Otra cosa distinta es que una empresa situada en segundo plano utilice ese correo (o una versión derivada del mismo) para concluir que el Becario que visita ese periódico es también el Becario que estuvo ayer en una tienda online y esta mañana en otra página. Esto es, simplificando mucho, lo que Apple quiere cortar.
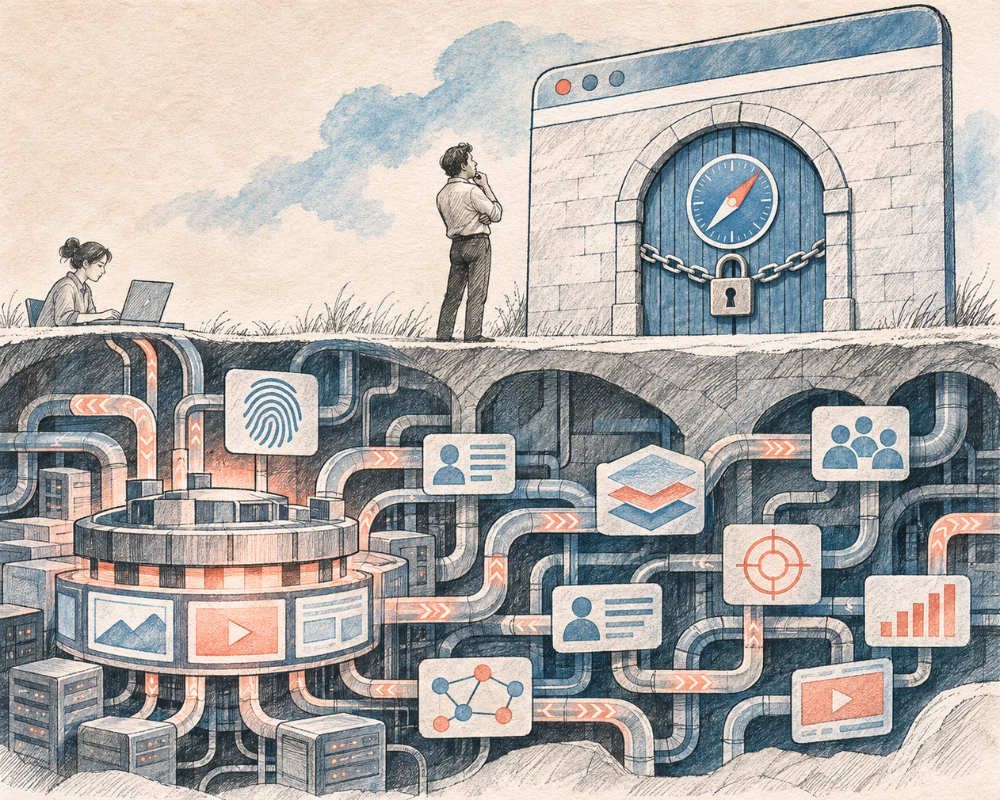
La reacción del mundo AdTech ha sido previsible: entre las empresas afectadas inicialmente por los cambios de WebKit aparecieron nombres como The Trade Desk, LiveRamp, ID5, Permutive o Audigent. Para parte de la industria, limitar estas infraestructuras perjudica al Open Internet porque dificulta que publishers y anunciantes reconozcan audiencias fuera de los grandes ecosistemas cerrados. El argumento tiene sentido, pero he encontrado un caso que hace bastante más difícil quedarse únicamente ahí. El 15 de octubre, Citizen Lab, de la Universidad de Toronto, publicó una investigación sobre Discover-Tech, una empresa israelí que consiguió utilizar la infraestructura de publicidad digital para localizar dispositivos y facilitar la instalación de spyware mercenario de Candiru. Según los investigadores, se trata de la primera confirmación técnica pública de una infección zero-click de este tipo distribuida mediante publicidad dirigida. La víctima no necesitaba pulsar un enlace extraño ni descargar un archivo: bastaba con que determinadas piezas publicitarias se cargaran en el dispositivo.
La dimensión del sistema tampoco era pequeña: Citizen Lab analizó unos 4.000 millones de registros de pujas de Discover-Tech y encontró actividad en cerca de 200.000 webs y aplicaciones durante cuatro meses. Dispositivos pertenecientes a Al Jazeera fueron objetivo de ataques vinculados con esta infraestructura y Candiru y aquí es donde una discusión que parecía exclusivamente publicitaria cambia bastante de aspecto. La infraestructura programática está diseñada para tomar decisiones extremadamente rápidas sobre una impresión: quién es el usuario, cuánto vale, quién quiere comprarla y qué anuncio debe aparecer. Normalmente utilizamos esa capacidad para vender zapatillas, coches o seguros, pero, técnicamente, esa misma infraestructura también puede utilizarse para localizar dispositivos muy concretos. No significa que la resolución de identidad sea spyware, obviamente, tampoco que los proveedores de identidad estén haciendo algo parecido a Discover-Tech. Esa sería una comparación injusta, pero creo que lo que demuestra el caso es otra cosa: una infraestructura diseñada para reconocer y alcanzar personas con enorme precisión puede tener usos que van mucho más allá de la publicidad… Y entonces aparece el segundo problema: Discover-Tech no es una empresa que estuviese escondida en un sótano digital completamente desconectado del sector. Citizen Lab documentó que figuraba desde 2020 tanto entre proveedores certificados de Google como en la Global Vendor List de IAB Europe. Tras conocer la investigación, Google eliminó el acceso de la compañía a sus plataformas e IAB Europe la suspendió.
Es difícil pedir a Apple que confíe plenamente en las listas de proveedores de nuestra industria cuando un actor relacionado con una operación de spyware ha podido formar parte de ellas durante años, y aquí merece la pena detenerse en algo que normalmente damos por resuelto con un banner. Cuando entramos en una página europea y pulsamos “Aceptar”, nuestro consentimiento puede viajar a través del TCF (Transparency & Consent Framework) hacia numerosos proveedores. Para el usuario medio, muchos de esos nombres son completamente desconocidos; el sistema funciona porque existe una cadena de confianza: el publisher confía en su CMP, el ecosistema confía en determinadas listas y todos asumimos que los proveedores que aparecen en ellas son quienes dicen ser y hacen aquello para lo que han declarado utilizar los datos. El caso Discover-Tech obliga, como mínimo, a preguntarse si la autoidentificación y el registro en una lista son suficientes. Citizen Lab sostiene que buena parte de estos sistemas dependen demasiado de declaraciones realizadas por los propios proveedores.
Esto no convierte automáticamente a Apple en el bueno de la película. La empresa ha recibido críticas razonables por la forma de aplicar estas restricciones: proveedores afectados denunciaron falta de transparencia sobre qué dominios estaban siendo bloqueados y ausencia de un mecanismo claro de apelación. AdExchanger documentó, además, al menos un caso en el que Google podía pujar por inventario en iOS mientras The Trade Desk no podía hacerlo… es decir, si vas a actuar como árbitro técnico de una parte importante de Internet, explicar las reglas parece una exigencia bastante básica y los publishers tienen un problema todavía más práctico: durante los últimos años se les ha pedido que construyan estrategias de first-party data para reducir su dependencia de las cookies. Muchos han creado sistemas basados en usuarios registrados, emails y proveedores externos capaces de convertir esas señales en identidades activables. Si Safari considera ahora que algunos de esos intermediarios son infraestructura de tracking, una parte de esa arquitectura vuelve a quedar en entredicho.
Apple dice que no quiere impedir que un medio utilice sus propios datos para personalizar publicidad dentro de sus propiedades. Ahí siguen estando el login, las relaciones directas con la audiencia, los datos first-party y, por supuesto, el contexto. Lo que cada vez parece tener menos recorrido en Safari es enviar una señal fuera para que un tercero pueda reconstruir a ese usuario en otros sitios. Tal vez esta sea la parte que deberíamos explicar mejor cuando hablamos del futuro de la identidad. Tradicionalmente la conversación se centró en encontrar “el sustituto de las cookies” y quizá esa pregunta estaba mal planteada: si el objetivo consiste en reconstruir por otra vía prácticamente la misma capacidad de seguir a una persona entre webs, Apple está dejando bastante claro que seguirá intentando bloquearla. Y después del caso Discover-Tech resultará algo más difícil responder simplemente que lo hace porque odia la publicidad.
El mundo AdTech tiene motivos para exigir transparencia a Apple, los publishers tienen todavía más motivos para preocuparse por decisiones tomadas unilateralmente desde Cupertino, pero nuestra industria también debería hacerse una pregunta bastante más cercana: si queremos que navegadores, anunciantes y usuarios confíen en nuestra infraestructura de identidad, ¿sabemos realmente quién tiene acceso a ella?
Puntos clave:
Apple considera que los sistemas de identity resolution que conectan a una persona entre distintas webs son una forma de tracking cross-site y WebKit ha empezado a bloquearlos.
Citizen Lab documentó el primer caso conocido de spyware mercenario distribuido mediante publicidad dirigida sin necesidad de que la víctima hiciera clic en el anuncio.
El problema para publishers y AdTech es real, pero también lo es una pregunta bastante incómoda: ¿hasta qué punto podemos pedir confianza en un ecosistema que no siempre sabe quién está participando en él?
Este resumen lo ha creado una herramienta de IA basándose en el texto del artículo, y ha sido chequeado por un editor de PROGRAMMATIC SPAIN.